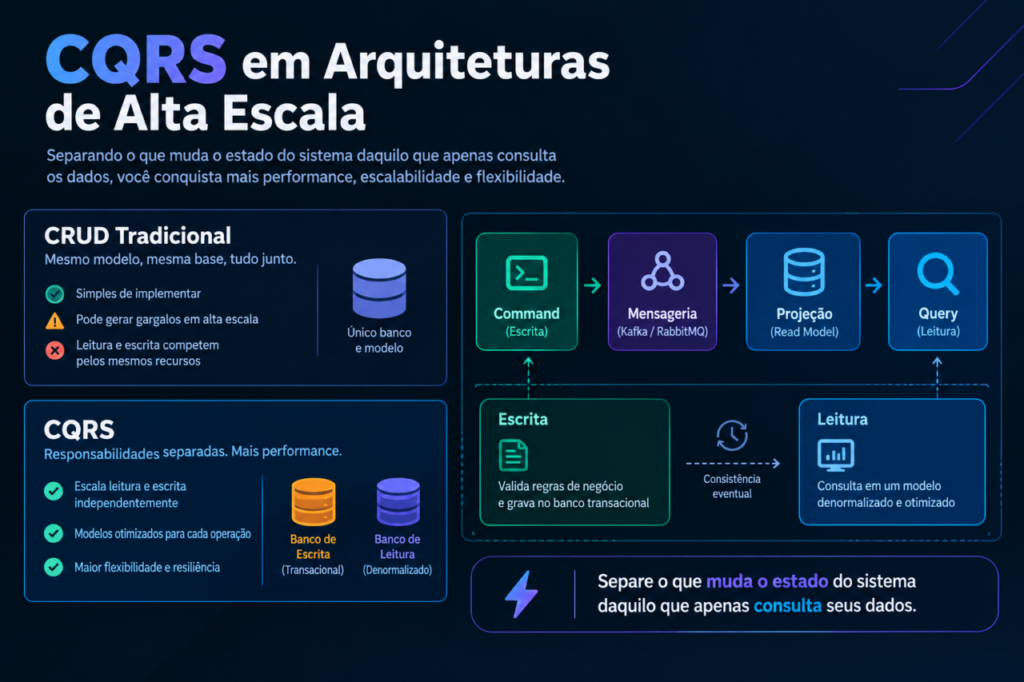
Em sistemas tradicionais (CRUD), utilizar a mesma estrutura de banco de dados e o mesmo modelo de objetos para gravar e consultar informações funciona bem até que o tráfego cresça. Em alta escala, as exigências de escrita (validação de regras de negócio, consistência transacional e dados normalizados) entram em conflito com as exigências de leitura (respostas em milissegundos, dados denormalizados e agregações complexas). Tentar otimizar uma única base para ambos os propósitos gera gargalos de desempenho e alto acoplamento.
A Abordagem Tradicional: Modelo Único (CRUD)
O fluxo convencional reutiliza as mesmas entidades para alterar o estado do sistema e para alimentar telas e relatórios. Para tentar amenizar lentidões na leitura, é comum recorrer a views, múltiplos índices ou réplicas de leitura simples.
Limitações do Modelo Único
- Contenção e Locking: Consultas analíticas pesadas concorrem por recursos diretamente com as transações de escrita;
- Modelos Poluídos: Entidades de domínio ficam repletas de atributos necessários apenas para exibição em tela;
- Conflito de Otimização: Criar múltiplos índices para acelerar leituras reduz a velocidade das gravações;
- Incapacidade de Escala Isolada: Obriga a escalar a infraestrutura de escrita na mesma proporção das consultas, mesmo quando há 100 leituras para cada 1 escrita.
A Abordagem Moderna: CQRS Pattern
O padrão CQRS (Command Query Responsibility Segregation) resolve esse conflito separando explicitamente as operações que alteram o sistema daquelas que apenas leem os dados. A aplicação passa a ser dividida em duas responsabilidades distintas:
- Command Side (Escrita): Recebe comandos de alteração (ex:
CriarPedidoCommand), focando estritamente em validações de negócio e consistência. - Query Side (Leitura): Trata consultas (ex:
GetDetalhesDoPedidoQuery), focando puramente em alta velocidade e devolvendo dados pré-formatados.
Como Funciona a Sincronização em CQRS Físico
- Gravação: O comando é processado e gravado no banco de escrita (ex: PostgreSQL).
- Evento: A alteração dispara um evento de domínio (ex:
PedidoCriadoEvent) para um intermediário de mensagens (como Kafka ou RabbitMQ). - Projeção: Um serviço consumidor lê o evento e atualiza o banco de leitura denormalizado (ex: Elasticsearch, MongoDB ou Redis).
- Consulta: A aplicação consulta diretamente a base de leitura, obtendo respostas instantâneas sem a necessidade de joins.
Estratégias de Implementação
1. CQRS Lógico (Mesmo Banco de Dados)
Separa apenas o código em comandos e consultas. A escrita utiliza um ORM tradicional e a leitura faz consultas SQL otimizadas diretamente em views ou tabelas dedicadas dentro do mesmo SGBD.
- Vantagens: Simplicidade de infraestrutura e melhor organização do código.
- Desvantagens: Mantém a disputa por hardware (CPU/RAM) no mesmo banco de dados.
2. CQRS Físico (Bancos de Dados Separados)
A escrita e a leitura utilizam bancos fisicamente distintos e especializados para cada finalidade.
- Vantagens: Escalabilidade independente, consultas ultra-rápidas e uso de persistência poliglota.
- Desvantagens: Maior complexidade operacional e introdução da consistência eventual (pequeno delay na sincronização).
Quando Utilizar Cada Abordagem?
- Use CRUD Tradicional quando: O sistema for simples, com volume moderado e regras de negócio diretas.
- Use CQRS Lógico quando: A lógica de escrita for complexa e você desejar organizar a arquitetura do código sem adicionar novos componentes de infraestrutura.
- Use CQRS Físico quando: Houver alta assimetria entre leituras e escritas, necessidade de respostas com baixíssima latência e o sistema já operar orientado a eventos.
Na prática, o CQRS Físico tornou-se essencial para sustentabilidade e alta performance em plataformas de grande porte que precisam escalar suas operações de leitura sem comprometer a integridade do negócio.