Em arquiteturas orientadas a eventos e microsserviços, o envio assíncrono de mensagens por meio de brokers (como RabbitMQ, Apache Kafka ou AWS SQS) é a base para garantir o desacoplamento e a escalabilidade do sistema. No entanto, o processamento dessas mensagens pelos microsserviços consumidores nem sempre ocorre com sucesso. Falhas temporárias de rede, indisponibilidade momentânea de dependências ou até mesmo mensagens malformadas (poison pills) podem fazer com que um consumidor falhe ao processar uma mensagem.
Se a aplicação simplesmente ignorar a falha, dados serão perdidos. Se tentar reprocessar a mensagem continuamente sem controle, o sistema entrará em um loop infinito, consumindo recursos computacionais e travando a fila de mensagens (head-of-line blocking).
A Abordagem Tradicional: Retentativas Síncronas Diretas
Historicamente, a tentativa de lidar com erros de consumo baseou-se em blocos de exceção (try-catch) com retentativas imediatas e síncronas na própria aplicação. Ao encontrar um erro, o código aguarda alguns milissegundos e tenta processar a mesma mensagem novamente na mesma chamada.
Limitações das Retentativas Síncronas
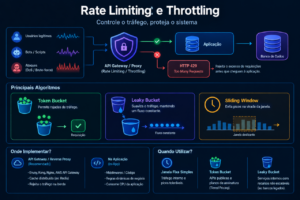
- Efeito Cascata e Sobrecarga: Se a falha for provocada por uma queda momentânea no banco de dados, retentativas imediatas de centenas de consumidores sobrecarregam ainda mais o banco, impedindo sua recuperação (Thundering Herd Problem);
- Bloqueio do Consumidor: A thread do consumidor fica presa aguardando os intervalos de retentativa, impedindo o processamento de outras mensagens válidas da fila;
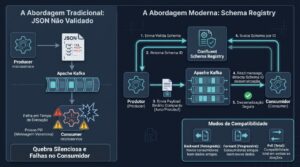
- Tratamento Indiferenciado: Falhas transitórias (rede instável) e falhas definitivas (JSON corrompido ou ID inexistente) são tratadas da mesma forma, gerando retentativas inúteis para dados inválidos.
A Abordagem Moderna: Estratégia de Retry com Backoff + DLQ
A solução moderna separa o tratamento de exceções em fases progressivas, combinando Exponential Backoff (atraso exponencial) com o padrão Dead Letter Queue (DLQ).
Em vez de prender a thread da aplicação, mensagens que falham são reenviadas para filas auxiliares com tempo de vida (Time-To-Live – TTL) ajustado ou desviadas para uma fila especial de mensagens mortas (DLQ), liberando o consumidor principal para continuar operando.
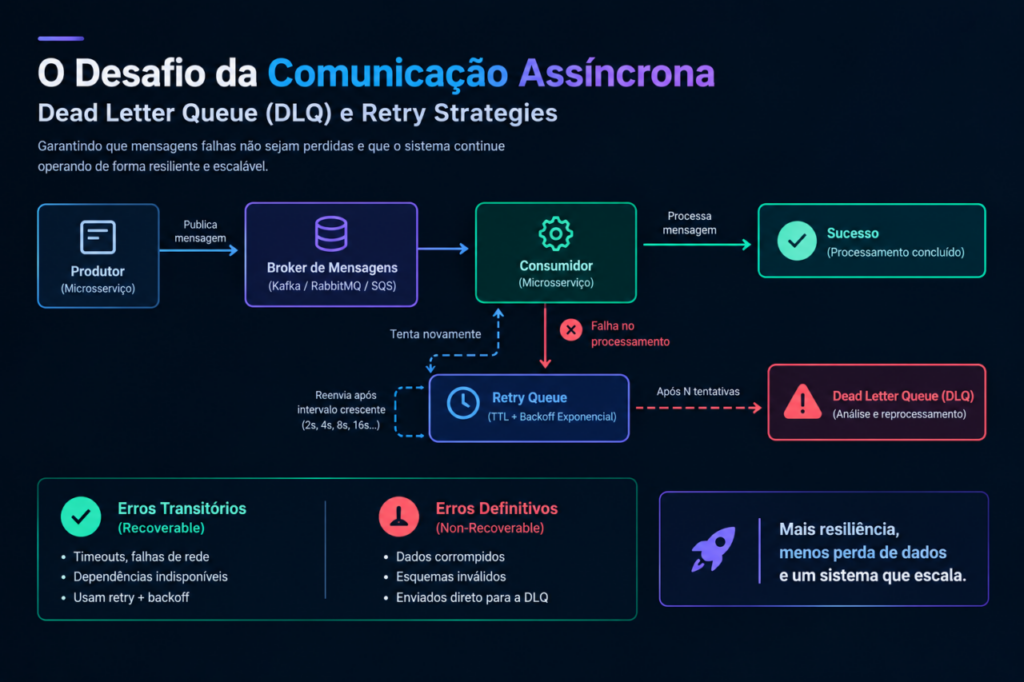
Como Funciona o Mecanismo
- Falha de Processamento: O consumidor falha ao processar uma mensagem da fila principal.
- Backoff Exponencial com Jitter: A mensagem é enviada para uma fila de retentativa (Retry Queue). A cada nova tentativa, o tempo de espera aumenta exponencialmente (ex: 2s, 4s, 8s, 16s) acrescido de uma variação aleatória (jitter) para evitar que múltiplas mensagens sejam reprocessadas ao mesmo tempo.
- Limite de Tentativas: A mensagem é reprocessada um número máximo fixo de vezes (ex: 3 tentativas).
- Encaminhamento para DLQ: Se todas as retentativas falharem, a mensagem é movida para a Dead Letter Queue (DLQ), onde fica armazenada sem expirar para análise posterior.
Estratégias de Gerenciamento de Exceções
Para uma implementação eficiente, a aplicação deve classificar as falhas em dois tipos:
1. Erros Transitórios (Recoverable Errors)
Falhas temporárias como timeouts de banco de dados, indisponibilidade momentânea de APIs externas ou oscilações de rede.
- Ação: Devem passar pelo fluxo de retentativa com Exponential Backoff antes de irem para a DLQ.
2. Erros Definitivos (Non-Recoverable Errors / Poison Pills)
Mensagens com dados corrompidos, esquemas inválidos ou violações de regras de negócio estáticas que jamais serão processadas com sucesso, independentemente de quantas retentativas sejam feitas.
- Ação: Devem ignorar o fluxo de retentativa e ser enviadas diretamente para a DLQ para evitar desperdício de processamento.
Quando Utilizar Cada Abordagem?
- Utilize Retentativas Simples na Aplicação quando: O sistema for de baixíssima complexidade e as falhas forem puramente operacionais de curtíssima duração (ex: retry de 1 a 2 vezes em memória).
- Utilize Retry Queues com Exponential Backoff quando: A garantia de processamento e a ordem relativa dos eventos forem cruciais e as dependências externas puderem sofrer indisponibilidades temporárias.
- Utilize Dead Letter Queue (DLQ) sempre que: Operar com mensagens assíncronas em microsserviços. A DLQ é indispensável para evitar perda de dados, permitir alertas de monitoramento (como no Datadog ou Prometheus) e viabilizar o reprocessamento manual ou automatizado após a correção de bugs.
Na prática, a combinação de Exponential Backoff com Dead Letter Queue é a estratégia padrão na engenharia de software para construir consumidores de mensagens altamente resilientes e tolerantes a falhas.