O que muda no Kubernetes 1.37 em uma leitura rápida
O que muda no HPA, no kubelet e no SELinux, e o que testar antes de atualizar seu cluster EKS.
O Kubernetes 1.37 já está disponível no Amazon EKS, e o upgrade não se resume a trocar um número no Terraform. A versão muda o comportamento padrão do SELinux em volumes, remove métricas usadas em muitos dashboards e libera o HPA para zerar réplicas.
Se você opera clusters em produção, este artigo mostra o que muda, o que quebra e o que testar antes de atualizar.
TL;DR
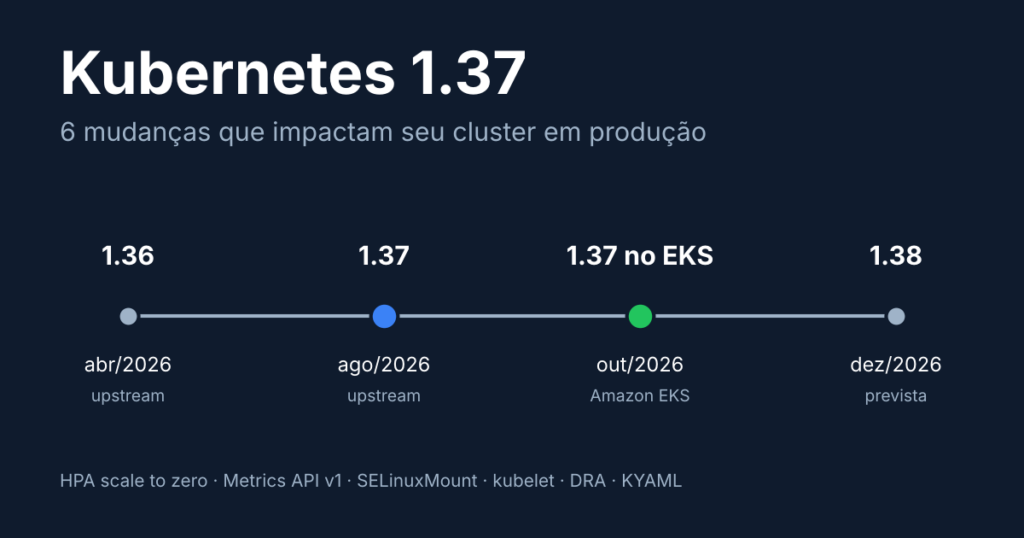
- O Kubernetes 1.37 saiu em 26/08/2026 e chegou ao Amazon EKS em 13/10/2026.
- O HPA agora escala a zero réplicas (beta, ativo por padrão), desde que use métricas Object ou External.
- A
metrics.k8s.io/v1virou estável, mas o controlador do HPA ainda consomev1beta1. Mantenha as duas versões. - O
SELinuxMountativo por padrão pode travar Pods emContainerCreatingquando eles compartilham volume. - O kubelet removeu três métricas do cAdvisor. Revise dashboards e alertas antes do upgrade.
- No EKS Auto Mode, NodePools novos sem política definida passam a usar consolidação
Balanced.
Por que o Kubernetes 1.37 importa agora
O Kubernetes 1.37, apelidado de “Garhwal”, foi lançado em 26 de agosto de 2026. A versão traz 67 melhorias: 16 promovidas a estável, 23 a beta, 27 entrando em alpha e 1 remoção.
O gatilho para escrever sobre ela agora é outro. Em 13 de outubro de 2026, a AWS anunciou o suporte ao Kubernetes 1.37 no EKS, em todas as regiões. Para quem roda cluster gerenciado, é a partir desse dia que o upgrade entra no backlog.
O ciclo não para. A próxima versão, a 1.38, está prevista para dezembro de 2026, e o projeto só mantém patches para as três versões mais recentes. Quem ainda está na 1.35 fica com pouca folga.
As 6 mudanças do Kubernetes 1.37 que afetam produção
Nem toda melhoria da versão chega ao seu dia a dia. As seis abaixo mudam comportamento padrão, quebram algo existente ou abrem uma economia real.
1. HPA scale to zero no Kubernetes 1.37
O HPA agora escala workloads até zero réplicas. O recurso está em beta, com o feature gate HPAScaleToZero ativo por padrão. Antes, isso exigia um add-on externo ou um gate alpha.
A regra que define tudo: só funciona com métricas Object ou External. CPU e memória vêm dos próprios Pods, então com zero réplicas não sobra sinal para escalar de volta. Já o tamanho de uma fila existe mesmo sem nenhum worker rodando.
Use em consumidores de fila, jobs batch e qualquer workload que reserve GPU. Evite em tráfego HTTP direto: um Service não segura requisições enquanto não há Pod pronto, então você precisa de uma camada de buffer na frente.
Exemplo de um worker que processa pedidos de uma fila, com uma réplica para cada 30 itens pendentes:
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: worker-pedidos
  namespace: pedidos
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: worker-pedidos
  minReplicas: 0
  maxReplicas: 20
  metrics:
  - type: External
    external:
      metric:
        name: fila_pedidos_pendentes
        selector:
          matchLabels:
            fila: pedidos
      target:
        type: Value
        value: "30"
Antes de aplicar, confirme que a métrica chega pela External Metrics API. Se ela não responder, o HPA não sai do zero:
kubectl get --raw \
  '/apis/external.metrics.k8s.io/v1beta1/namespaces/pedidos/fila_pedidos_pendentes?labelSelector=fila%3Dpedidos'
2. Metrics API estável
A metrics.k8s.io chegou à versão v1 depois de quase nove anos em beta. Os campos são idênticos aos da v1beta1. Muda só a versão da API.
O detalhe que pega times desatentos: o kubectl top já prefere a v1, mas o controlador do HPA ainda consome apenas a v1beta1 no Kubernetes 1.37. Se o seu metrics-server passar a servir só a v1, o autoscaling por CPU e memória para de funcionar. Mantenha as duas versões ativas.
kubectl get --raw /apis/metrics.k8s.io/ | jq '.versions'
kubectl get apiservice v1.metrics.k8s.io
3. SELinuxMount ativo por padrão
Esta é a mudança com maior risco de incidente. Com o SELinuxMount ligado, o kubelet monta o volume já com o rótulo SELinux, em vez de reetiquetar arquivo por arquivo. O ganho é velocidade na subida do Pod.
O problema: um mount carrega um único rótulo. Se dois Pods no mesmo nó compartilham um volume com rótulos, seLinuxChangePolicy ou nível de privilégio diferentes, o segundo fica preso em ContainerCreating. Nós sem SELinux habilitado não são afetados.
Para manter o comportamento anterior, defina Recursive em todos os Pods que dividem o volume:
spec:
  securityContext:
    seLinuxChangePolicy: Recursive
O blog oficial sobre a mudança no SELinux detalha os cenários de conflito.
4. Métricas e flags removidas do kubelet
O kubelet do Kubernetes 1.37 deixou de expor três métricas do cAdvisor: container_cpu_load_average_10s, container_cpu_load_d_average_10s e container_tasks_state. Qualquer painel ou alerta que dependa delas fica vazio, em qualquer AMI.
Duas outras mudanças afetam quem usa AMI customizada:
- O kubelet não inicia se houver flag depreciada do cAdvisor, exceto
--housekeeping-interval. eventRecordQPS: 0passou a significar “sem limite”. Antes, aplicava 5 eventos por segundo. Para manter o comportamento antigo, troque para5.
5. Taints e tolerations em GPUs com DRA
O Dynamic Resource Allocation agora permite aplicar taints em dispositivos, como GPUs, e o recurso chegou a estável. O scheduler evita alocar uma GPU com taint para Pods que não a toleram.
Na prática, você tira de circulação uma GPU com defeito ou em manutenção sem drenar o nó inteiro. Ao criar um DeviceTaintRule, sempre defina spec.deviceSelector. Para atingir todos os dispositivos, use deviceSelector: {}.
6. KYAML estável e tolerância configurável no HPA
Duas mudanças menores, mas úteis no dia a dia:
- KYAML estável: o subconjunto mais seguro de YAML, introduzido em alpha na 1.34, chegou a estável. Ele elimina ambiguidades clássicas do YAML na saída do kubectl.
- Tolerância do HPA por objeto: a tolerância deixa de ser só o padrão global de 10%. Agora você define valores separados para subir e descer.
spec:
  behavior:
    scaleUp:
      tolerance: 0.05
    scaleDown:
      tolerance: 0.15
Com esse ajuste, o HPA reage rápido a picos e evita derrubar réplicas por oscilações pequenas.
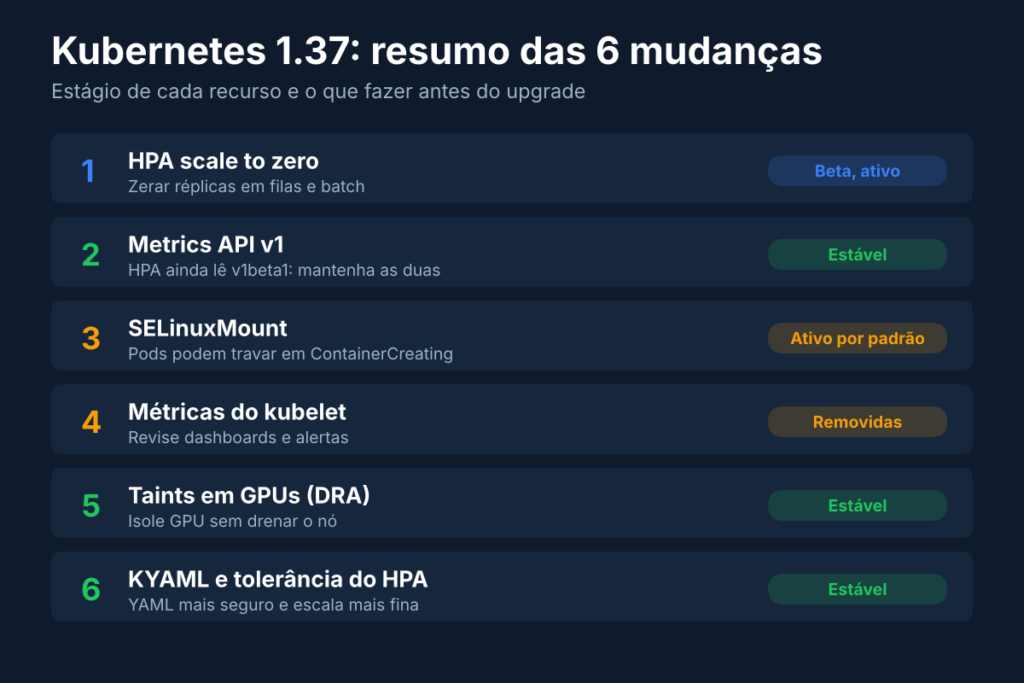
Kubernetes 1.37 no Amazon EKS
As notas de versão do EKS trazem pontos que não aparecem no anúncio upstream. Estes são os que mais afetam quem opera na AWS:
- Consolidação no EKS Auto Mode: NodePools novos sem
consolidationPolicypassam a usarBalancedem vez deWhenEmptyOrUnderutilized. Segundo a AWS, isso gera menos evictions com custo parecido. Os NodePools nativosgeneral-purposeesystemficam fixos emBalanced. - Adapter de métricas por sua conta: o EKS não instala adapter de métricas Object ou External. Sem ele, o scale to zero do HPA não funciona.
- Driver DRA também: o EKS não instala driver DRA. O driver DRA da NVIDIA funciona com Karpenter em capacidade estática, managed node groups e nós self-managed, mas não com EKS Auto Mode.
- Instâncias G7: exigem o driver NVIDIA 595. As AMIs NVIDIA do Amazon Linux 2023 já trazem esse driver. No Bottlerocket NVIDIA, ele vem a partir do Kubernetes 1.37.
Se você usa Auto Mode e depende do comportamento antigo de consolidação, declare a política explicitamente nos seus NodePools. O trecho abaixo mostra só o campo relevante; mantenha o restante da sua especificação:
apiVersion: karpenter.sh/v1
kind: NodePool
metadata:
  name: workloads-gerais
spec:
  disruption:
    consolidationPolicy: WhenEmptyOrUnderutilized
Checklist de upgrade para o Kubernetes 1.37
Rode estes comandos primeiro em staging. Cada um cobre um dos riscos descritos acima.
# 1. Insights de upgrade do EKS (APIs depreciadas, add-ons, nós)
aws eks list-insights --cluster-name <NOME_DO_CLUSTER> --region <REGION>

# 2. Drivers CSI com seLinuxMount habilitado
kubectl get csidriver \
  -o custom-columns=NAME:.metadata.name,SELINUXMOUNT:.spec.seLinuxMount

# 3. Versões servidas pela Metrics API (precisa listar v1beta1)
kubectl get --raw /apis/metrics.k8s.io/ | jq '.versions'

# 4. Dashboards e alertas que usam métricas removidas
grep -rlE 'container_cpu_load_(d_)?average_10s|container_tasks_state' ./observabilidade/

# 5. Upgrade do control plane
aws eks update-cluster-version \
  --name <NOME_DO_CLUSTER> \
  --kubernetes-version 1.37 \
  --region <REGION>
Depois do control plane, atualize os add-ons gerenciados e só então os nós. Em clusters com managed node groups, faça um grupo por vez e acompanhe os eventos dos Pods.
Armadilhas comuns no upgrade
- Pular versão: o EKS só sobe uma versão menor por vez. Da 1.35, passe pela 1.36 primeiro e trate a remoção do volume
gitRepoe a validação estrita de IP/CIDR. - Scale to zero em API HTTP: sem buffer, as requisições falham enquanto o primeiro Pod sobe. Reserve o recurso para filas e batch.
- Metrics-server só com v1: derruba o autoscaling por CPU e memória, porque o HPA ainda lê a
v1beta1. - Volume compartilhado entre Pod privilegiado e não privilegiado: sem
seLinuxChangePolicy: Recursive, o segundo Pod não sobe em nós com SELinux.
Custo, segurança e observabilidade
Custo. O scale to zero elimina o último Pod ocioso de cada fila. A economia é maior em workloads que reservam GPU ou CPU dedicada, como inferência em batch. O preço é o cold start: entre a mensagem chegar e o Pod processar, há o tempo de agendar e subir a aplicação. Isso conversa direto com o pilar de otimização de custos do AWS Well-Architected.
Segurança. O kubelet do Kubernetes 1.37 passou a registrar toda a sua configuração efetiva no log de inicialização. Restrinja quem lê logs de nó, inclusive no CloudWatch, com políticas IAM de menor privilégio. No SELinux, prefira resolver conflitos de rótulo a desligar o recurso.
Observabilidade. Troque os painéis que usavam container_tasks_state e as médias de carga de CPU por métricas de throttling e uso. Para filas com scale to zero, monitore a idade da mensagem mais antiga, não só o tamanho da fila. É ela que mostra se o cold start está estourando seu SLO.
Para ouvir os bastidores da versão, vale o episódio do Kubernetes Podcast com o líder da release do Kubernetes 1.37.
Conclusão
O Kubernetes 1.37 é uma versão de estabilidade, mas com três armadilhas reais: SELinux em volumes compartilhados, métricas removidas do kubelet e a Metrics API servida só em v1. Em troca, entrega scale to zero nativo no HPA e controle fino sobre GPUs.
Próximo passo: rode o checklist acima em um cluster de staging nesta semana. Agende o upgrade de produção só depois de validar os dashboards e os Pods que compartilham volume.
Referências
Todas consultadas em 20/10/2026.
- Kubernetes v1.37: Garhwal (anúncio oficial)
- Kubernetes v1.37: Scale Workloads to Zero with HorizontalPodAutoscaler
- Kubernetes v1.37: Metrics API graduates to stable
- SELinux Volume Label Changes goes GA (and likely implications in v1.37)
- Amazon EKS: notas das versões em suporte padrão
- Amazon EKS and Amazon EKS Distro now support Kubernetes version 1.37
- Kubernetes 1.37 Released: Stable Metrics API and Rootless Kubelet in Beta (InfoQ)
- CHANGELOG completo do Kubernetes 1.37