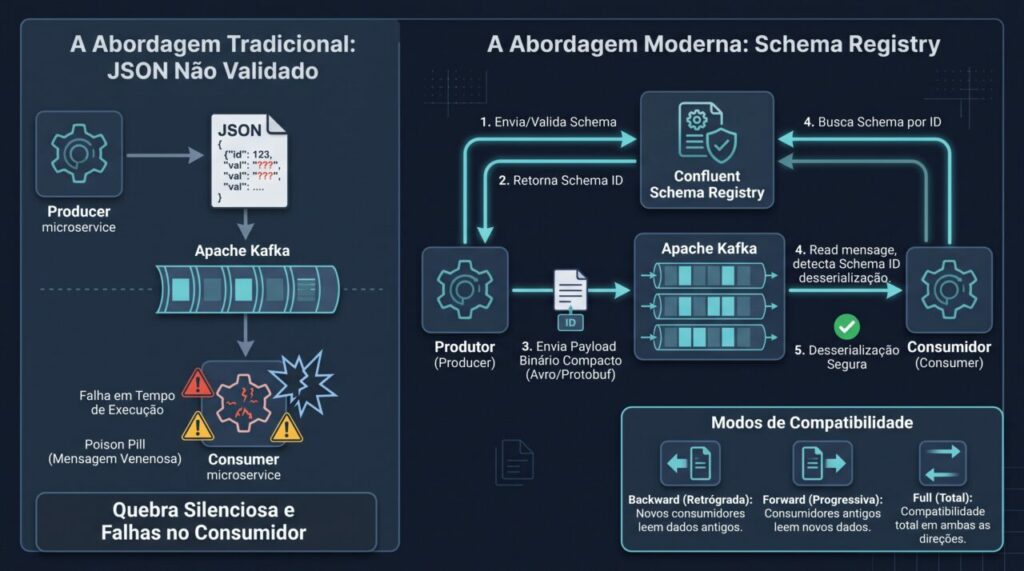
Em sistemas orientados a eventos com centenas de microsserviços trocando mensagens em tempo real (utilizando Apache Kafka com serializadores binários como Apache Avro, Protocol Buffers ou JSON Schema), o desacoplamento temporal é a regra: os produtores (producers) e consumidores (consumers) operam de forma totalmente assíncrona e independente.
No entanto, as regras de negócio evoluem continuamente. Campos precisam ser adicionados, renomeados, tipos de dados alterados e atributos obsoletos removidos dos eventos. Se um produtor alterar a estrutura do evento (schema) sem aviso e publicar mensagens com a nova versão, todos os consumidores legados que não foram atualizados falharão instantaneamente ao tentar desserializar a mensagem, paralisando a esteira de processamento (Poison Pill em escala).
A Abordagem Tradicional: JSON Não Validado e Acordo Humano
A abordagem tradicional baseia-se no envio de payloads em JSON puro sem catálogo de esquemas formal. Mudanças de formato de mensagens são combinadas por alinhamentos entre os times de desenvolvimento ou documentadas em wikis internas.
Limitações do Formato Livre
- Quebra Silenciosa em Tempo de Execução: Erros de tipagem (ex: transformar uma
stringem umarray) só são detectados quando o consumidor em produção quebra ao tentar fazer o parse; - Payloads Excessivamente Pesados: O formato JSON repete os nomes de todas as chaves a cada evento transmitido na rede, gerando desperdício massivo de banda e armazenamento em brokers de alta vazão;
- Ausência de Governança de Dados: Não há visibilidade de quais serviços consomem quais versões de dados, transformando qualquer refatoração em um processo de alto risco.
A Abordagem Moderna: Confluent Schema Registry e Verificação de Compatibilidade
A solução definitiva para gerenciar a evolução de dados em mensageria é o uso de formatos binários estruturados (como Apache Avro) gerenciados por um componente central de governança: o Schema Registry.
O Schema Registry atua como a autoridade central de contratos de dados do ecossistema. Ele armazena as versões dos esquemas, atribui um ID único a cada formato e atua como um portão de validação (guardrail) que impede que qualquer produtor publique dados que quebrem os consumidores existentes.
Como Funciona o Mecanismo
- Registro do Esquema: Antes de enviar uma mensagem, o cliente do produtor registra a nova versão do esquema no Schema Registry.
- Validação de Regras de Compatibilidade: O Schema Registry avalia se a alteração obedece às políticas de governança configuradas. Se for compatível, armazena o novo esquema e retorna um
Schema ID(ex: ID 42). - Serialização Eficiente: O produtor serializa apenas o payload binário compacto e anexa apenas o
Schema ID(apenas 5 bytes) no início da mensagem, eliminando nomes de colunas repetidos. - Desserialização sob Demanda: Ao ler a mensagem do Kafka, o consumidor extrai o
Schema ID, consulta o Schema Registry uma única vez (mantendo-o em cache local) e desserializa os dados com segurança garantida.
Modos de Compatibilidade de Esquemas
O Schema Registry suporta diferentes políticas de governança para controlar a evolução dos dados:
1. Backward Compatibility (Compatibilidade Reversa – Padrão)
Garante que os novos consumidores possam ler dados produzidos por produtores legados.
- Regra: Você pode remover campos ou adicionar novos campos opcionais (que possuam um valor padrão – default value).
- Fluxo de Deploy: Os consumidores devem ser atualizados para a nova versão antes dos produtores.
2. Forward Compatibility (Compatibilidade Futura)
Garante que consumidores legados que ainda estão rodando possam continuar lendo dados gerados por produtores atualizados.
- Regra: Você pode adicionar novos campos ou remover campos opcionais. Os consumidores antigos simplesmente ignoram os atributos desconhecidos.
- Fluxo de Deploy: Os produtores são atualizados antes dos consumidores.
3. Full Compatibility (Compatibilidade Total)
Combina Backward e Forward Compatibility. Qualquer versão do consumidor consegue ler dados de qualquer versão do produtor.
- Regra: Exige que qualquer novo campo adicionado ou removido possua obrigatoriamente um valor default. É o modo mais seguro para grandes organizações com dezenas de microsserviços autônomos.
Quando Utilizar Cada Abordagem?
- Utilize JSON Não Validado quando: O projeto for um MVP simples, de poucos serviços, com tráfego reduzido e mantido por um único desenvolvedor.
- Utilize Schema Registry com Backward Compatibility quando: O ecossistema operar pipelines analíticos ou de ingestão de dados onde as esteiras consumidoras (ex: data lakes, data warehouses) evoluem mais rápido que as aplicações de origem.
- Utilize Schema Registry com Full Compatibility quando: O sistema operar em arquitetura corporativa de alta escala com múltiplos times descentralizados compartilhando os mesmos tópicos no Apache Kafka, onde a garantia de zero downtime na evolução dos contratos for inegociável.