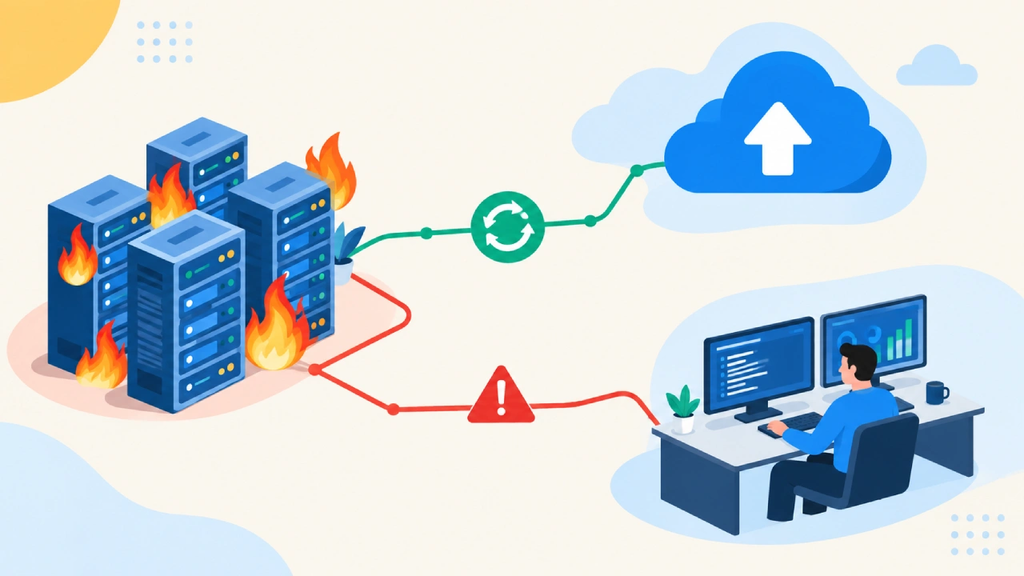
Imagine que, de uma hora para outra, um sistema essencial para sua empresa fique indisponível.
Pode ser uma falha de infraestrutura, um problema de software, uma exclusão acidental de dados, uma indisponibilidade regional ou até mesmo um incidente de segurança.
Quanto tempo sua empresa conseguiria ficar sem esse sistema?
E, principalmente: quantos dados poderiam ser perdidos sem causar um impacto significativo para o negócio?
Essas perguntas estão diretamente relacionadas a dois conceitos fundamentais de uma estratégia de Disaster Recovery (DR): RTO (Recovery Time Objective) e RPO (Recovery Point Objective).
Mais do que manter cópias dos dados, uma estratégia de Disaster Recovery busca preparar a organização para recuperar sistemas, aplicações e informações dentro de objetivos previamente definidos.
Na AWS, existem diferentes estratégias para recuperação de workloads, que podem variar desde backup e restauração até arquiteturas distribuídas em múltiplas regiões. A escolha depende dos requisitos de negócio, do nível de criticidade da aplicação, dos objetivos de recuperação e dos custos envolvidos.
O que é Disaster Recovery?
Disaster Recovery, ou recuperação de desastres, é o conjunto de estratégias, processos e tecnologias utilizados para recuperar sistemas e dados após um evento que comprometa a operação normal de uma empresa.
Esse evento pode ter diferentes origens, como:
- Falhas de hardware ou infraestrutura;
- Indisponibilidade de sistemas;
- Erros humanos;
- Exclusão ou corrupção de dados;
- Falhas de software;
- Incidentes de segurança;
- Problemas em um ambiente ou região;
- Desastres físicos que afetem a infraestrutura.
O objetivo de um plano de DR não é necessariamente impedir que um incidente aconteça. O foco é preparar a organização para responder e recuperar suas operações quando um evento ocorrer.
Por isso, Disaster Recovery está diretamente relacionado à resiliência e continuidade dos negócios.
Backup é a mesma coisa que Disaster Recovery?
Não.
Essa é uma das principais diferenças que as empresas precisam entender.
Um backup é uma cópia dos dados que pode ser utilizada para recuperação.
Já o Disaster Recovery envolve uma estratégia mais ampla, que considera não apenas os dados, mas também a infraestrutura, aplicações, configurações, conectividade, processos de recuperação e a forma como o ambiente será colocado novamente em operação.
Imagine, por exemplo, que uma empresa tenha um backup atualizado do seu banco de dados.
Se o servidor que executa a aplicação estiver indisponível, a empresa ainda precisará reconstruir ou recuperar a infraestrutura necessária para que a aplicação volte a funcionar.
É por isso que uma estratégia de DR precisa considerar o ambiente como um todo.
A própria AWS recomenda avaliar e testar regularmente a estratégia de recuperação para verificar se os objetivos definidos podem ser alcançados quando necessário.
RTO e RPO: dois indicadores fundamentais
Antes de definir uma arquitetura de Disaster Recovery, é necessário entender quanto tempo a empresa pode ficar parada e quanto de informação pode ser perdida.
É nesse ponto que entram RTO e RPO.
O que é RTO?
RTO (Recovery Time Objective) é o tempo máximo aceitável para que um serviço seja recuperado após uma interrupção.
Por exemplo:
Uma aplicação possui um RTO de 30 minutos.
Isso significa que a estratégia de recuperação deve ser planejada para que o serviço volte a operar dentro desse objetivo.
O RTO é definido de acordo com as necessidades do negócio. Sistemas mais críticos podem exigir tempos de recuperação menores, enquanto aplicações menos críticas podem tolerar períodos maiores de indisponibilidade.
O que é RPO?
RPO (Recovery Point Objective) representa a quantidade máxima de dados que a empresa está disposta a perder, medida em relação ao momento anterior ao incidente.
Por exemplo:
Uma empresa define um RPO de 15 minutos.
Nesse cenário, a estratégia de proteção dos dados deve buscar limitar a perda a esse intervalo, de acordo com a arquitetura e os mecanismos de recuperação utilizados.
RPO e RTO não são valores que devem ser escolhidos apenas com base na tecnologia disponível. Eles precisam refletir o impacto que uma indisponibilidade ou perda de dados teria para o negócio.
Quais são as principais estratégias de Disaster Recovery na AWS?
A AWS apresenta quatro estratégias principais de recuperação de desastres:
- Backup e restauração;
- Pilot Light;
- Warm Standby;
- Multi-site Active/Active.
Essas estratégias representam diferentes níveis de preparação, complexidade operacional e investimento.
1. Backup e restauração
É uma das abordagens mais simples.
Os dados são protegidos por backups e, em caso de desastre, os recursos necessários são provisionados ou recuperados e os dados são restaurados.
Essa estratégia pode ser adequada para workloads que não exigem tempos de recuperação extremamente baixos.
Por outro lado, como parte da infraestrutura precisa ser recuperada durante o processo, o RTO tende a ser maior do que em estratégias mais avançadas.
Na AWS, serviços como AWS Backup podem ser utilizados para configurar, automatizar e monitorar backups de determinados recursos.
2. Pilot Light
Na estratégia conhecida como Pilot Light, os dados são replicados para uma região ou ambiente de recuperação, enquanto parte da infraestrutura necessária para executar a aplicação permanece desativada ou precisa ser provisionada durante a recuperação.
Essa abordagem pode proporcionar tempos de recuperação menores do que uma estratégia exclusivamente baseada em backup e restauração, mantendo uma estrutura de recuperação com menor utilização de recursos do que uma arquitetura totalmente ativa.
3. Warm Standby
No Warm Standby, uma versão reduzida, mas funcional, da aplicação permanece disponível no ambiente de recuperação.
Em caso de desastre, essa infraestrutura pode ser ampliada para atender à carga necessária.
Como parte do ambiente já está em funcionamento, essa estratégia tende a oferecer recuperação mais rápida do que o Pilot Light, embora também envolva maior custo e complexidade operacional.
4. Multi-site Active/Active
Na estratégia Multi-site Active/Active, o workload é executado simultaneamente em mais de uma região ou localidade, com os ambientes atendendo tráfego de forma ativa.
Essa abordagem pode proporcionar objetivos de recuperação muito baixos, mas também é a estratégia mais complexa operacionalmente entre as quatro apresentadas pela AWS.
Além disso, a sincronização e o gerenciamento dos dados entre ambientes precisam ser cuidadosamente projetados.
Por isso, uma arquitetura Active/Active não deve ser escolhida simplesmente porque oferece um nível elevado de disponibilidade. Ela precisa fazer sentido para os requisitos específicos do negócio.
Disaster Recovery precisa ser testado
Ter uma documentação dizendo como recuperar um ambiente não significa necessariamente que a empresa esteja preparada para um desastre.
Um dos pontos mais importantes de uma estratégia de DR é testar o processo de recuperação.
Isso permite verificar, na prática:
- Se os backups estão realmente utilizáveis;
- Se os dados podem ser restaurados;
- Se a infraestrutura pode ser recuperada;
- Se as aplicações funcionam após o processo;
- Se as configurações necessárias estão disponíveis;
- Se as permissões e acessos estão funcionando;
- Se os tempos de recuperação estão próximos dos objetivos definidos.
A AWS recomenda testes regulares da estratégia de Disaster Recovery para aumentar a confiança de que ela poderá ser executada quando necessária.
Esse ponto é especialmente importante porque replicação não substitui backup.
Se um dado for excluído ou corrompido e essa alteração for replicada para o ambiente secundário, a cópia também poderá ser afetada. Por isso, uma estratégia de DR precisa considerar mecanismos de backup e recuperação para retornar a um estado anterior quando necessário.
Disaster Recovery não significa necessariamente Multi-Region
Existe uma percepção comum de que uma estratégia de DR precisa obrigatoriamente utilizar duas regiões da AWS.
Não necessariamente.
A estratégia adequada depende do tipo de incidente que a empresa deseja suportar e dos seus requisitos de negócio.
Uma aplicação pode utilizar mecanismos de alta disponibilidade dentro de uma região, enquanto workloads com requisitos específicos podem demandar uma estratégia de recuperação entre regiões.
A própria AWS destaca que estratégias Multi-Region devem ser avaliadas de acordo com os requisitos do workload e que arquiteturas Multi-AZ podem oferecer proteção adequada contra diversos tipos de desastre.
Por isso, antes de definir uma arquitetura, é importante responder:
“Contra qual cenário estamos tentando nos proteger?”
Essa pergunta ajuda a evitar arquiteturas excessivamente complexas ou investimentos que não estejam alinhados às necessidades reais da empresa.
AWS Elastic Disaster Recovery
Para determinados cenários, a AWS oferece o AWS Elastic Disaster Recovery (AWS DRS).
O serviço permite replicar continuamente servidores de origem para uma área de staging e realizar a recuperação das aplicações em uma região de recuperação quando necessário.
A AWS apresenta o Elastic Disaster Recovery como uma alternativa que pode oferecer objetivos de RPO e RTO semelhantes aos de uma estratégia Warm Standby, mantendo na região de recuperação apenas os recursos necessários para a replicação enquanto a recuperação não é iniciada.
O uso do serviço, entretanto, precisa ser avaliado de acordo com o ambiente e com os requisitos específicos de cada workload.
Como escolher uma estratégia de DR?
Não existe uma única arquitetura de Disaster Recovery adequada para todas as empresas.
A decisão deve começar pelos requisitos do negócio.
Algumas perguntas importantes são:
- Qual é o sistema mais crítico da empresa?
- Quanto tempo ele pode ficar indisponível?
- Quantos dados podem ser perdidos?
- Quais são as consequências financeiras de uma parada?
- Existem requisitos regulatórios ou de compliance?
- Qual cenário de desastre precisa ser coberto?
- Onde os backups estão armazenados?
- Os backups são testados?
- Quanto tempo leva para recuperar o ambiente atualmente?
- Existe documentação do processo?
- Quem é responsável pela recuperação durante um incidente?
- Quanto a empresa está disposta a investir em resiliência?
A partir dessas respostas, é possível avaliar qual estratégia faz sentido para cada workload.
Uma empresa pode, inclusive, utilizar estratégias diferentes para aplicações diferentes. Um sistema extremamente crítico pode demandar uma arquitetura mais robusta, enquanto uma aplicação de menor impacto pode utilizar backup e restauração. A AWS reconhece essa possibilidade ao recomendar que as estratégias sejam escolhidas de acordo com os objetivos de recuperação de cada workload.
Disaster Recovery na prática: o case da Chatuba Construção
Um exemplo da importância de uma estratégia de recuperação pode ser encontrado em um projeto realizado pela KXC Tecnologia para a Chatuba Construção.
Antes da implementação da nova arquitetura, o ambiente da empresa utilizava SQL Server em infraestrutura física e possuía backup em fita local sem testes de restauração. De acordo com o case publicado pela KXC, o RPO estimado era superior a quatro horas e o RTO estava entre quatro e oito horas.
A KXC realizou um assessment e uma revisão baseada no AWS Well-Architected Framework, identificando riscos relacionados a confiabilidade, segurança e excelência operacional.
Como parte da solução, o ambiente foi migrado para o Amazon RDS for SQL Server com Multi-AZ, proporcionando uma arquitetura com redundância entre Availability Zones.
Além disso, a solução passou a utilizar:
- AWS Backup;
- Snapshots diários do RDS;
- Armazenamento de backup no Amazon S3;
- Replicação dos backups para outra região;
- Testes mensais de restauração;
- Monitoramento do ambiente;
- Controles de segurança e criptografia.
Segundo o case publicado pela KXC, o ambiente passou a apresentar um RTO efetivo inferior a cinco minutos e RPO inferior a cinco minutos, além de disponibilidade mensal de 99,98%.
Esse projeto demonstra um ponto importante: uma estratégia de resiliência não depende apenas de possuir uma cópia dos dados. É necessário combinar arquitetura, redundância, backup, monitoramento e testes de recuperação de acordo com os requisitos do negócio.
Como a KXC Tecnologia pode apoiar sua estratégia de Disaster Recovery
Construir uma estratégia de DR exige uma visão que combine tecnologia e negócio.
A KXC Tecnologia atua com projetos AWS envolvendo arquitetura de cloud, migração e modernização, segurança, operação e otimização de ambientes.
A empresa utiliza práticas relacionadas ao AWS Well-Architected Framework para avaliar workloads e identificar oportunidades de melhoria em aspectos como confiabilidade, segurança, desempenho e eficiência operacional.
Em projetos de Disaster Recovery, isso pode envolver etapas como:
Assessment → Definição de RTO/RPO → Análise de riscos → Desenho da arquitetura → Implementação → Automação → Testes → Monitoramento
O objetivo é construir uma estratégia compatível com a criticidade de cada aplicação, evitando tanto ambientes vulneráveis quanto arquiteturas mais complexas do que o necessário.
Sua empresa está preparada para uma indisponibilidade?
Uma falha pode acontecer mesmo em ambientes modernos e altamente tecnológicos.
A diferença está em como a empresa está preparada para responder quando ela acontecer.
Ter backups é importante.
Ter alta disponibilidade é importante.
Mas uma estratégia completa de Disaster Recovery precisa responder a uma pergunta ainda mais importante:
“Se o pior cenário acontecer hoje, sabemos exatamente como recuperar nossa operação?”
Se a resposta ainda não está clara, esse pode ser o momento de avaliar a resiliência do seu ambiente.
A KXC Tecnologia pode ajudar sua empresa a avaliar a infraestrutura atual, identificar riscos, definir objetivos de recuperação e estruturar uma estratégia de Disaster Recovery alinhada às necessidades do negócio e às possibilidades da AWS.
Fale com a KXC Tecnologia e descubra como tornar seu ambiente mais resiliente e preparado para os desafios do negócio.
Fontes
- AWS Well-Architected Framework — Planejamento para recuperação de desastres: estratégias de recuperação, RTO, RPO e recomendações de arquitetura.
- AWS — Disaster Recovery of Workloads on AWS: estratégias de Backup & Restore, Pilot Light, Warm Standby e Multi-site Active/Active.
- AWS Prescriptive Guidance — Defining your disaster recovery strategy: comparação entre estratégias e objetivos de recuperação.
- AWS — Elastic Disaster Recovery: utilização do AWS DRS em estratégias de recuperação.
- KXC Tecnologia — Case Chatuba Construção: arquitetura AWS, Multi-AZ, AWS Backup, recuperação e testes de restore.
- KXC Tecnologia — Amazon AWS: serviços e atuação da KXC em arquitetura, migração, segurança, operação e otimização AWS.
Keep your eXperience in Cloud.